本文首发于微信公众号「电商超声波」:原文链接
导语:这周在学 SQL 窗口函数,正好读到 GitHub 上 xiaomaxueshufen/data-analysis 项目里的一份《RFM 分层方法包》(references/methods/rfm.md),里面一句话把我点醒了——“RFM 是分位切点 + 标签,不是预测模型。“做了几年电商数据中台,我发现 RFM 被误用得比不用更可怕。本文结合这份方法包的观点和我自己的实战(示例数据已脱敏),讲透 3 个误用,外加一套窗口函数实战 SQL。
一、这个论点从哪来
先交代来源,避免空泛议论。论点出自 GitHub 项目 xiaomaxueshufen/data-analysis 中的《RFM 分层方法包》(references/methods/rfm.md,2026 年更新)。它的核心立场非常鲜明:
RFM 的输出是”哪些用户最近买过、买得多、买得贵”,不能直接用于”哪些用户会响应某次营销”。后者需要 uplift 模型,没有 uplift 就不写”响应率”。
换句话说,RFM 只是一个描述性分层工具:把用户按 R(最近一次消费距今)、F(消费频次)、M(消费金额)切分位、打标签。它不预测未来,不估计因果。
我认同这个立场,而且是在中台里被坑过之后认同的。下面三个误用,每一个我都见过真实版本。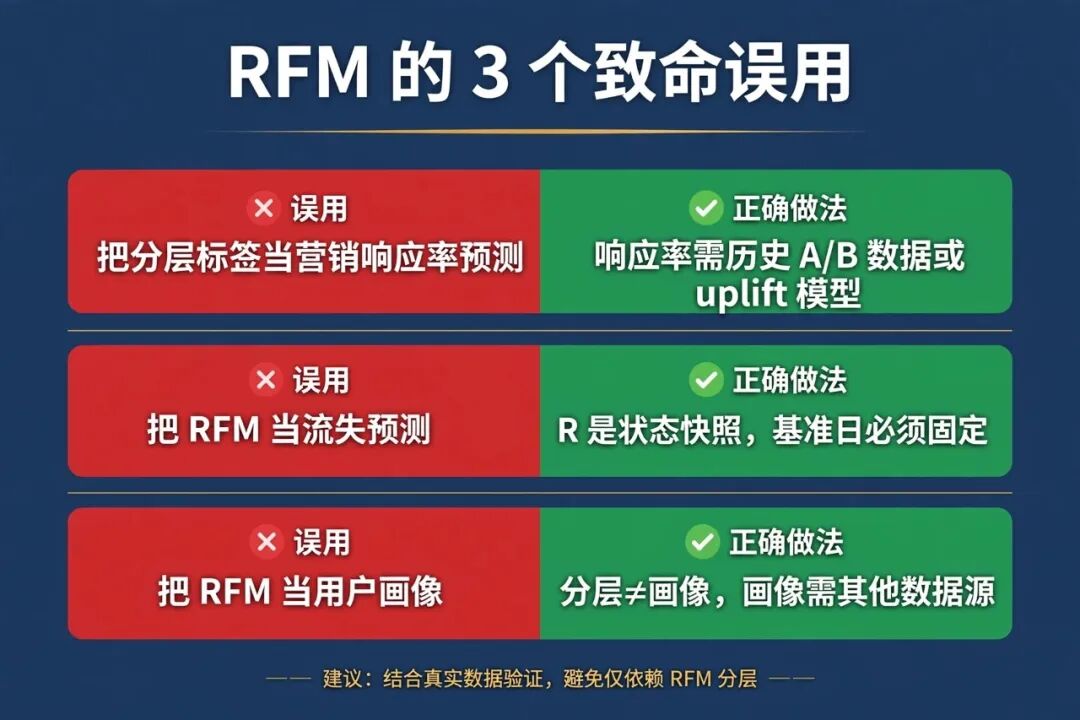
二、误用一:把分层标签当营销响应率预测
典型话术:“Champions 用户的营销响应率 30%,发券 ROI 最高,先发他们。”
为什么错:响应率是一个因果量——“发了券之后,有多少人因为券而买”。RFM 标签里没有任何关于”对营销敏感”的信息。Champions 只是”最近买得多”,不代表”对券敏感”,甚至可能恰恰相反:他们本来就要买。
实战印证:我们中台 RFM 看板上线后,业务方第一件事就是圈出 Champions 发大额券。结果核销率还不如”即将流失的高 M 用户”那一批。复盘发现:Champions 的券,大部分补贴了本来就会发生的订单——增量几乎为零。方法包里有句话说得很准:“不要写’高 R + 高 M 贡献 X% 的金额’,X% 是值,不是增量。要增量,还得看是否迁移自其他层。”
正确做法:分层只回答”找谁”,响应预测必须靠历史 A/B 实验数据,或者上 uplift 模型。没有 uplift,就老老实实不写”响应率”三个字。
三、误用二:把 RFM 当流失预测
典型话术:“R 分最低的那批用户就是要流失的用户,赶紧召回。”
为什么错:R 是”距离上次购买的天数”,是一个状态快照,不是”未来 30 天流失概率”。方法包明确指出:不要把 RFM 当 churn 预测,它缺乏时间窗口预测能力。
更坑的是一个工程细节:R 会漂移。如果 reference_date(统计基准日)不显式固定,这周跑出来的 R 和上周跑出来的 R,口径根本不在一条线上,跨期完全不可比。我们就吃过这个亏:大促之后全员 R 值变小,“流失用户”一夜之间”复活”了——动的不是用户,是口径。
正确做法:reference_date 必须显式指定并固定(比如每月 1 号跑批);分位切点随报告一起输出保存,跨期对比时先对齐切点。真要做流失预测,请用生存分析或分类模型,别为难 RFM。
四、误用三:把 RFM 当用户画像
典型话术:“Champions 主要是 25–35 岁高线城市女性,推品往这个方向走。”
为什么错:方法包的原话是——“用户分层 ≠ 用户画像。任何把 RFM 当画像写的都是越权,必须从其他数据源拿。“R/F/M 只描述交易行为,不包含年龄、城市、兴趣、偏好。把行为标签直接翻译成人口画像,属于典型的越权推断。
实战印证:我们曾按”高 M = 高消费力”的逻辑,给一批高 M 用户推高客单新品,结果退货率奇高。深挖发现,那批”高 M”里混着一批公司采购代下单的账号——行为上像高价值用户,画像上完全不是一回事。从那以后,我们中台的 RFM 看板旁边永远挂着一行小字:“分层描述行为,不描述人。”
正确做法:画像去接 CRM 标签、行为埋点、调研数据。RFM 做好分层这一件事就够了。
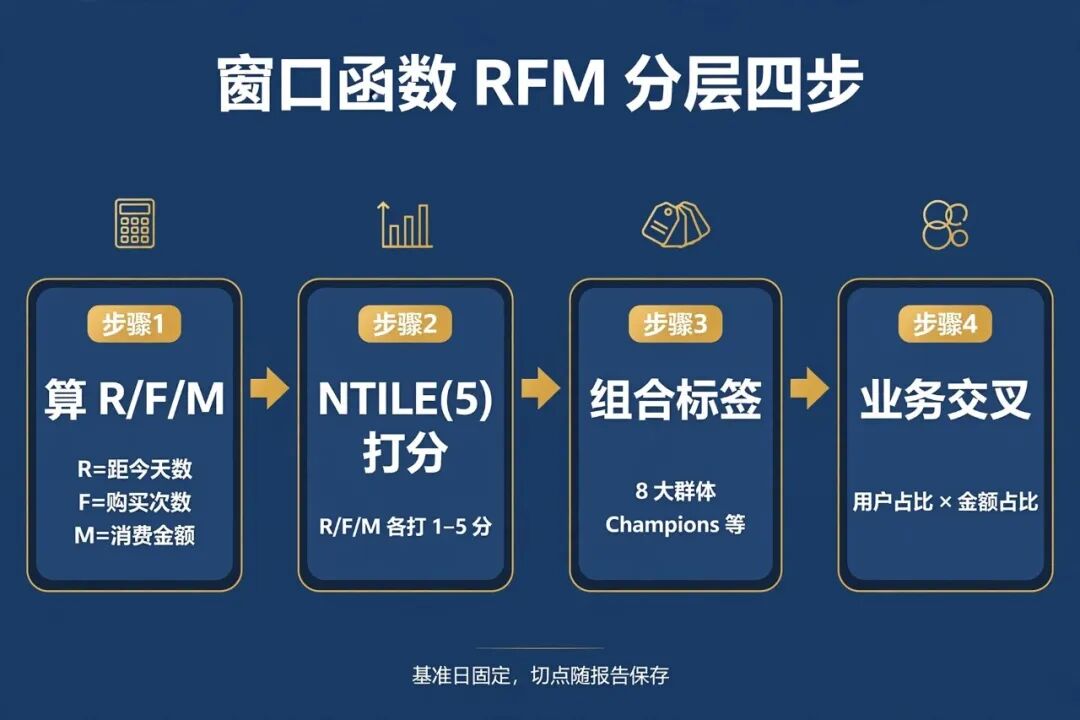
五、窗口函数实战:一套 SQL 跑出规范的 RFM
Week 2 正在学的窗口函数,在 RFM 里有个教科书级的用法:用NTILE(5)做分位打分。下面这套 SQL 在 MySQL 8 / Hive / Spark SQL 里通用:
-- 基准日必须显式固定,否则 R 漂移、跨期不可比 WITH user_rfm AS ( SELECT buyer_id, DATEDIFF('2026-10-01', MAX(order_date)) AS recency_days, -- R:越小越好 COUNT(*) AS frequency, -- F:越大越好 SUM(pay_amount) AS monetary -- M:越大越好 FROM dwd_order_di WHERE dt BETWEEN '2026-07-01' AND '2026-10-01' AND order_status NOT IN ('refunded', 'cancelled') GROUP BY buyer_id HAVING COUNT(*) >= 2 -- 单次购买不构成 RF,归入"未分层" ), scored AS ( SELECT *, NTILE(5) OVER (ORDER BY recency_days ASC) AS r_score, -- R 越小分越高 NTILE(5) OVER (ORDER BY frequency DESC) AS f_score, NTILE(5) OVER (ORDER BY monetary DESC) AS m_score FROM user_rfm ) SELECT buyer_id, r_score, f_score, m_score, CASE WHEN r_score >= 4 AND f_score >= 4 THEN 'Champions 冠军用户' WHEN r_score >= 4 AND f_score <= 2 THEN 'New 新用户' WHEN r_score <= 2 AND f_score >= 4 THEN 'At Risk 即将流失' WHEN r_score <= 2 AND f_score <= 2 THEN 'Hibernating 沉睡' ELSE 'Others 待细分' END AS segment FROM scored;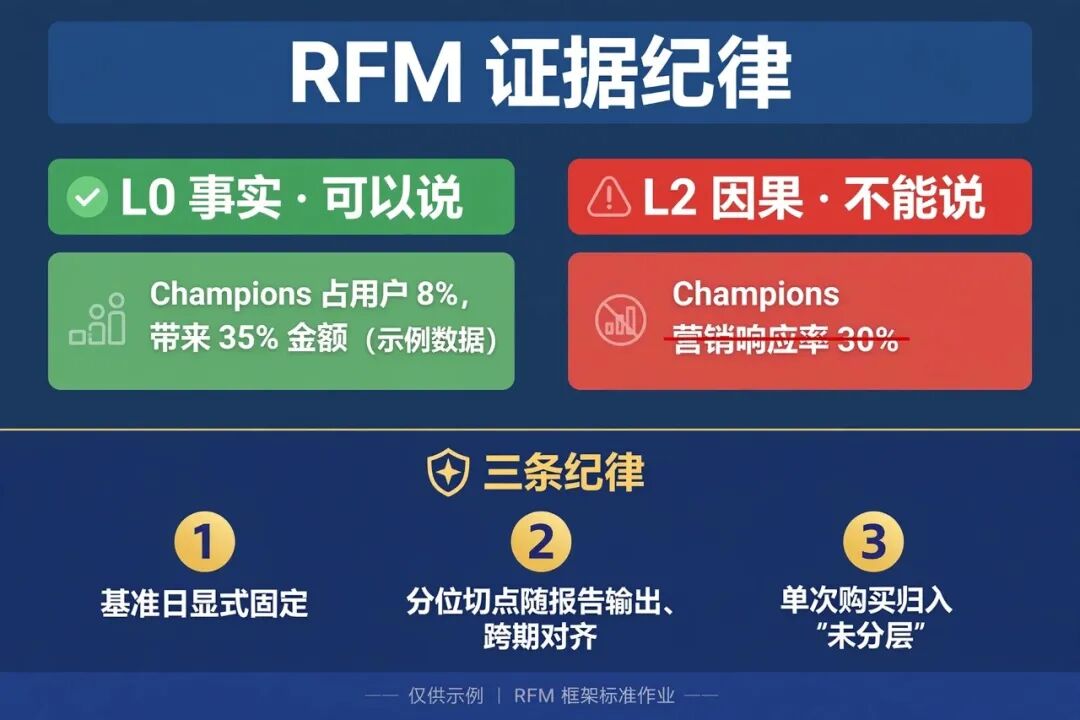
三个细节,呼应方法包的纪律:
-
M 长尾先做 winsorize:金额分布极重(比如混着 B2B 大单)时,先取 log 或截断 1%/99% 分位再 NTILE,否则头部用户永远单成一档,分位失去意义。
-
R 的排序方向别写反:NTILE(5) OVER (ORDER BY recency_days ASC) 让”最近购买”得高分。新手最容易在这里把 ASC/DESC 写反,整个分层全错。
-
切点存表、跨期对齐:把每期的分位边界值存下来。下期”Champions 变多了”,先对齐切点再下结论——可能是切点变了,不是用户变了。
分层之后再做业务交叉:各层的用户占比 vs 金额占比(share_of_entities / share_of_monetary)。示例数据:Champions 占用户 8%,带来 35% 的金额。记住方法包的证据纪律——这是 L0 事实(可以说),但不能直接上升为 L2 因果(不可以说”所以 Champions 营销响应率最高”)。
六、结尾:RFM 是起点,不是终点
RFM 回答的是”用户现在在哪”,不回答”用户下一步去哪”。分层做完,真正的活才开始:在运营动作里验证假设,在实验设计里度量增量。